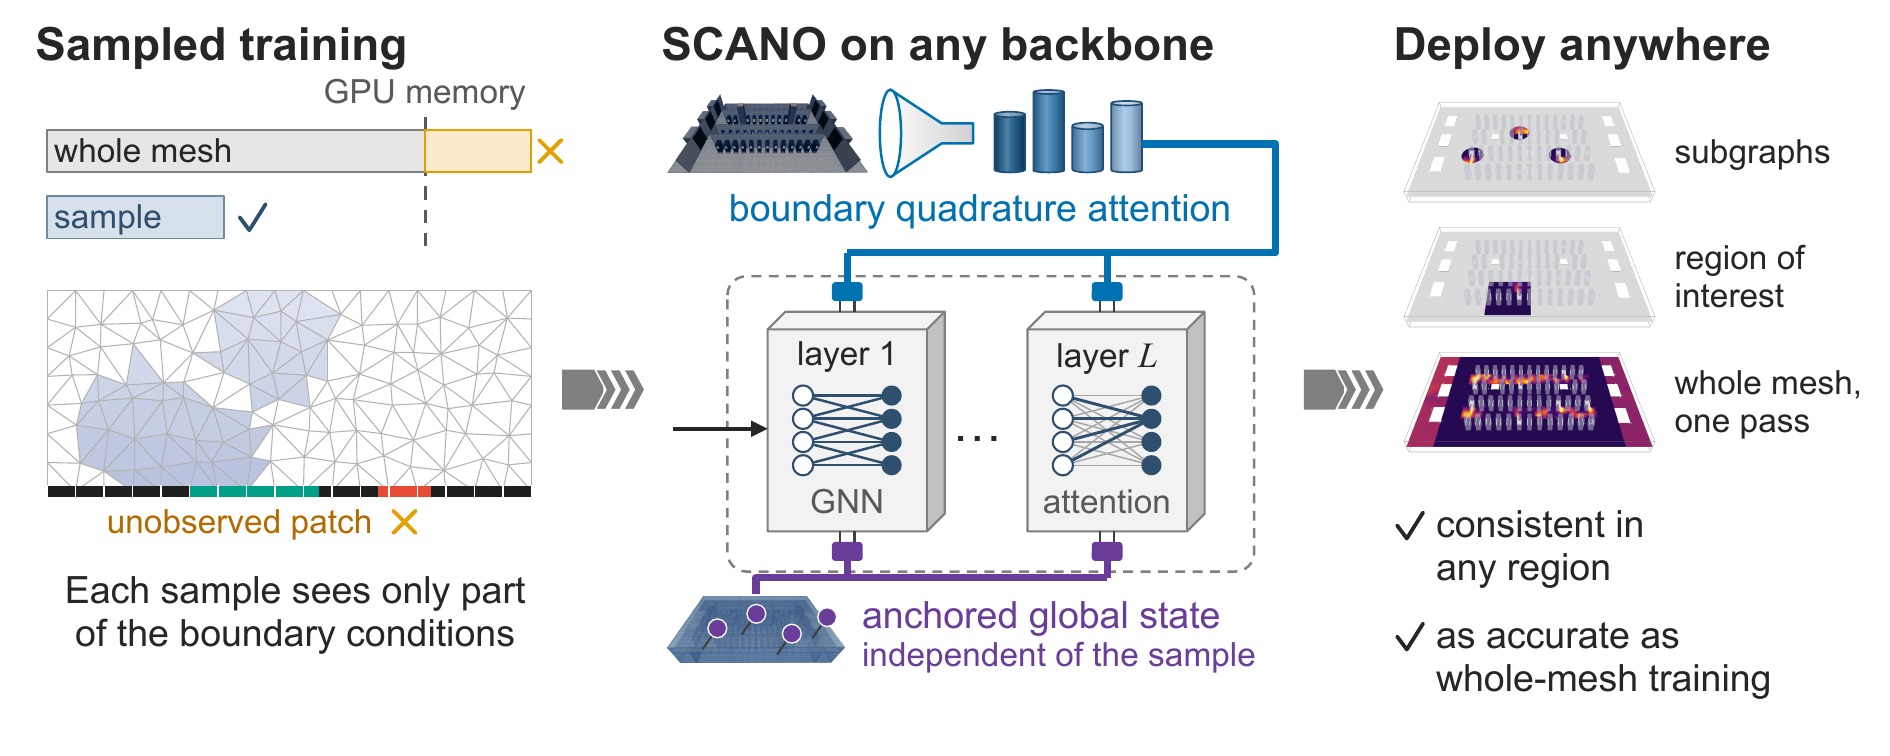
百万网格放不进 GPU 显存,神经算子只能在网格样本上训练,每次只看到一部分边界条件。我们提出 SCANO,用两个即插即用模块让采样训练与整网格训练保持一致,并以不到一秒的单次前向预测整个数据中心机房。 在一个风冷数据中心机房里,十几台到两百多台服务器同时发热。冷却单元把冷风从地板下送入冷通道,服务器把热风排向机柜背后的热通道,热空气再回到冷却单元。服务器的进风温度有严格的热工规范 [1],所以热工工程师要回答的问题都很具体:哪些服务器有过热风险?某个机柜的功率升高、某台冷却单元的风量减小时,各台服务器的进风温度会怎样变化? 每回答一个这样的问题,都需要做一次计算流体力学(CFD)仿真:在约一百万个网格单元上求解稳态、带浮力的湍流。在我们的测试中,一个机房从划分网格到完成求解需要将近二十分钟。 神经算子(neural operator)走的是另一条路:直接学习从边界条件到物理场的求解映射。训练好之后,预测一个物理场只需要数值求解器耗时的一小部分 [2–4]。 但到了百万网格的工程问题上,神经算子先要过 GPU 显存这一关。本文介绍我们组的工作 SCANO,它关心的是显存限制带来的一个具体问题:当模型只能在网格的采样子图上训练时,边界条件应当如何聚合、如何注入,才能让训练出的模型与完整网格训练的模型一致。 图1|SCANO 概览。左:在百万网格上,一个训练步放不下整张网格,只能在子图样本上训练,而每个子图样本只看得到一部分边界条件。中:SCANO 的两个模块,边界求积注意力(BQA)与锚定全局状态(AGS),可以接入任意主干网络。右:同一组权重可以部署到子图、感兴趣区域或整个网格,在任何区域都保持一致,精度与整网格训练相当。(来源:论文 Graphical Abstract) 一次放不下整张网格:采样训练是一种折中 训练神经算子时,一个训练步所需的显存随网格规模增长。在一个约百万网格的 DCTS 机房上,对整个房间做一次训练步,每一种主干网络都要占用单张 GPU 的大部分显存。带消息传递的 SCANO 主干则直接超出显存(图2a)。网格再大一些,所有主干都会超出单张 GPU 的显存。 一种办法是把网格切分成带晕区(halo)的子图,做区域分解。不做区域分解时,则直接在网格的采样子图上训练:随机抽取一部分点 [5]、随机抽取锚点 [4],或者从随机种子出发生长出局部子图 [6]。训练完成后,再把模型部署到整张网格,或者只部署到工程师关心的局部区域。 这些做法都是显存限制下的折中,受影响最大的是边界条件是否能被完整考虑。 每个采样子图只看得到一部分边界条件 在我们构建的数据中心数据集 DCTS 中,每个机房有数百个边界区块(patch),多的超过一千个。它们分属服务器进风口、服务器出风口、冷却单元的送风口与回风口、墙面、开孔地板等不同的物理角色(图2b、c)。同一个区块内,面元的面积也可能相差几个数量级。每个区块都有自己的给定值、换热系数、通量或热负荷,机房内部的温度场与速度场就由这些边界数据决定。 神经算子要把这些边界信息送到计算域内的每一个点,通常分两步。第一步是聚合:把边界面元的数据整理成网络能读取的形式,例如边界节点的特征、一个汇总向量或一组 token。第二步是注入:把这些信息送进计算域内的点,可以只在输入层注入一次,也可以在每一层注入。采样训练时,这两步都可能出错。 在模型的一次前向过程中,一个采样子图样本能覆盖 DCTS 机房中近 40% 的内部网格单元,却只覆盖约三分之一的服务器出风口,而服务器出风口是整个机房热场的热源。最容易漏掉的是最小的区块,比如单台服务器的出风口、冷却单元的格栅,而工程师关心的变化多半就来自这些地方。 图2|采样训练的显存与三个数据集的边界统计。(a) 在一个 DCTS 机房上,一次优化步的峰值显存随样本覆盖的房间比例增长;叉号表示超出 GPU 显存,虚线为单张 GPU 的可用显存,点线为训练所用的设置。(b) 每个算例的边界区块数(灰色为训练与验证集,蓝色为测试集)。(c) 各类边界与物理角色所占的比例。(来源:论文图2) […]
Read More