讨论计算系统的碳排放时,运行阶段的用电往往最先受到关注。但在服务器、GPU、CPU、内存和存储真正投入使用之前,原材料、晶圆制造、化学气体、封装等环节已经产生了大量碳排放。这部分排放通常被称为隐含碳(Embodied Carbon)。
传统核算方法通常为同一类硬件提供一个平均隐含碳参数。例如,同样属于 7nm 工艺的 CPU,若只依据产品类别、工艺节点和芯片面积进行估算,不同产品实例很容易被视为具有相同或相近的碳足迹。问题在于,真实制造过程并不发生在“平均地点”和“平均时间”。
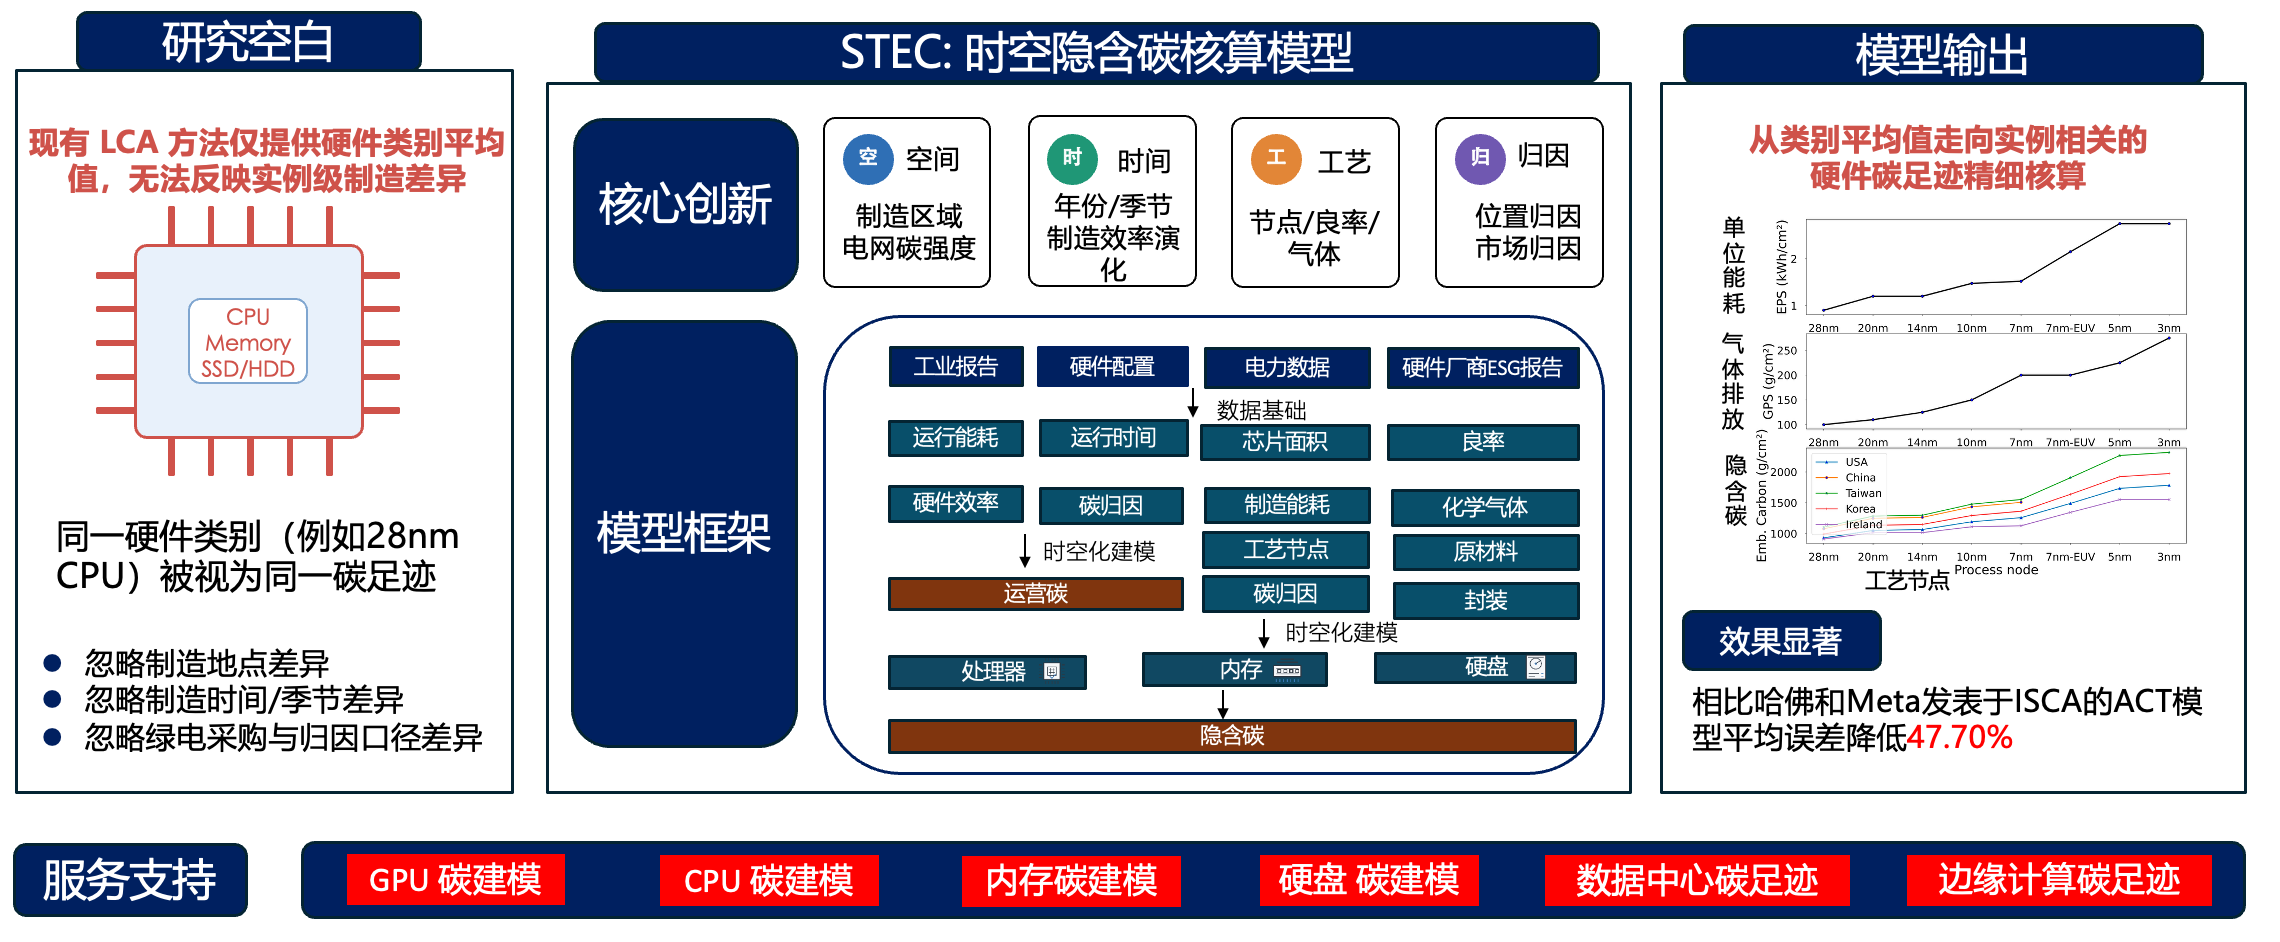
一颗芯片在哪里制造、在什么时间制造,以及制造商如何采购和归属绿色电力,都会改变制造用电对应的碳强度。由此,同一产品类别中的具体硬件实例,也可能具有不同的隐含碳。为此论文提出了面向计算机系统的时空隐含碳核算模型STEC [1],如图1所示。
为什么“同一种芯片”并不一定对应同一个碳足迹?
计算硬件制造与电力系统紧密相关。以论文中的 7nm CPU 参数为例 [1],制造阶段约 61% 的碳排放来自电力消耗,其余主要来自化学气体和原材料。因此,当制造用电的碳强度发生变化时,最终隐含碳也会随之变化。
电力碳强度本身具有明显的空间和时间差异。不同地区的煤电、天然气、核电、风电和太阳能占比不同;同一地区的可再生能源供给又会随着季节和天气变化。除此之外,企业还可能通过 Power Purchase Agreement(PPA,购电协议)采购可再生能源,而不同的碳归因方法会进一步改变企业所对应的电力碳强度。
从类别平均值,到时空隐含碳核算
针对上述问题,STEC模型保留处理器、内存和存储制造过程中与能耗、材料和化学气体相关的参数,同时将制造用电的碳强度表示为制造地点 s 和时间 t 的函数。
模型进一步区分两种碳归因方式:
- STEC-L(Location-based):基于位置的核算。制造商按照所在电网的整体发电结构计算用电碳强度。
- STEC-M(Market-based):基于市场的核算。企业通过 PPA 等方式采购的绿色电力可被单独归属,同时还需要考虑电网 residual mix(剩余电力组合)的变化。
空间和时间会带来多大的差异?
论文将 STEC 与已有的 ACT 模型 [2] 进行比较,并覆盖 7nm CPU、10nm DDR4 内存、SSD 和 HDD。结果显示,只要把制造地点和制造时间纳入核算,隐含碳结果就会出现不可忽略的变化。
在国家-周粒度下,四类硬件相对 ACT 的平均差异为 10.38%,平均最大差异达到 36.34%;在国家-季节粒度下,平均差异为 13.33%,平均最大差异为 27.50%。其中,7nm CPU 的平均差异为 13.69%,SSD 为 16.51%,HDD 为 10.36%,内存为 12.74%。
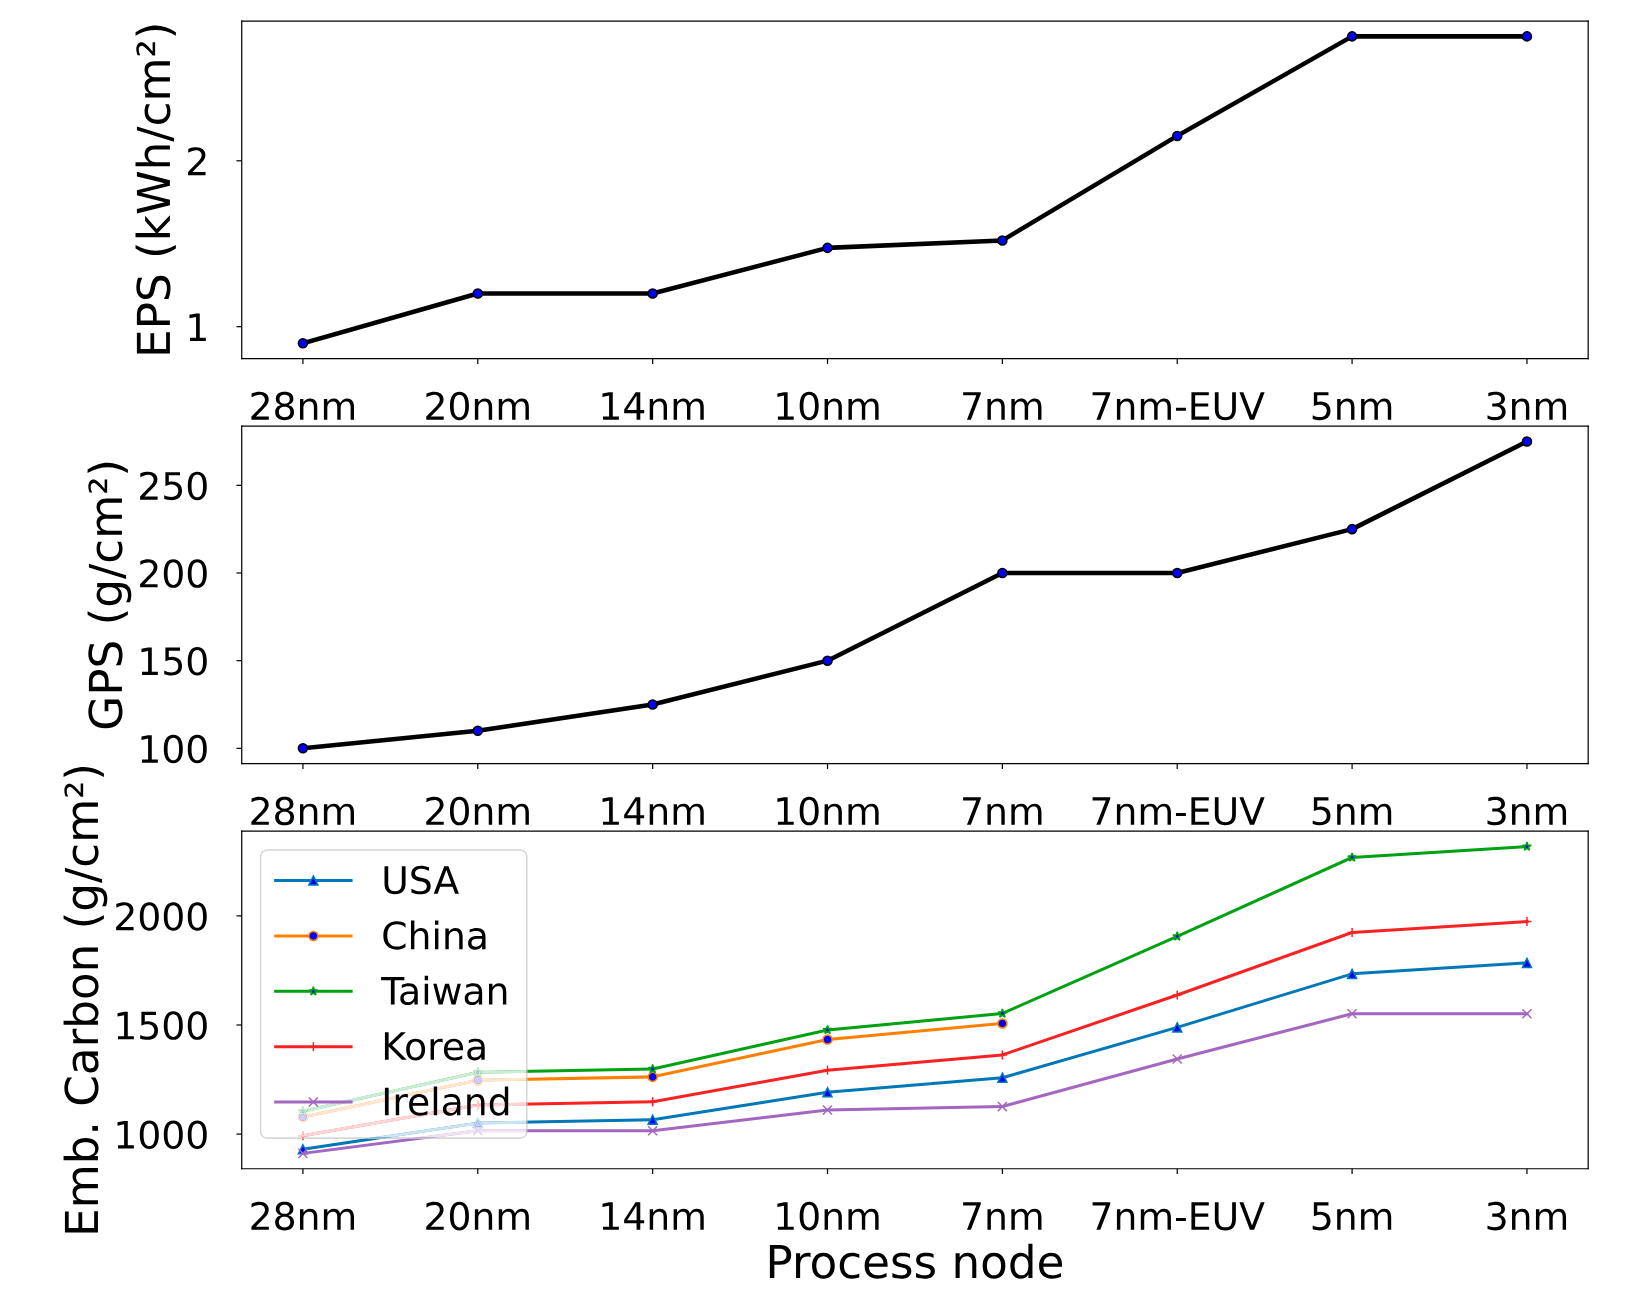
先进工艺节点对电力碳强度变化更加敏感。论文从 28nm 到 3nm 的分析表明,随着单位芯片面积的制造能耗和部分工艺排放上升,电力碳强度在隐含碳中的影响被进一步放大,如图2。
季节变化也并非在所有地区呈现相同方向。爱尔兰的绿色电力以风电为主,冬季风能更充足,因此制造对应的隐含碳往往更低;意大利则更依赖太阳能,夏季呈现相反趋势。换言之,“低碳制造窗口”取决于具体电网结构,而不能只用统一的季节判断。
绿电采购为什么也会改变硬件的隐含碳?
如果只使用电网平均碳强度,企业通过 PPA 采购可再生能源的影响很难被准确体现。STEC-M模型 [1] 将这种市场化绿电归属纳入核算。论文以 2021 年 TSMC 和 Intel 的公开数据为例:TSMC 约 9.2% 的用电由 PPA 覆盖,而 Intel 的比例约为 80%。在 STEC-M-CW 下,两者相对 ACT 的平均差异分别为 9.59% 和 37.39%。
这里还有一个容易忽略的细节:当一部分可再生能源通过 PPA 被特定企业“认领”后,剩余电网的电源结构也会改变。由此,residual mix 的碳强度可能高于原始电网平均值。因此,市场法并不是简单地在企业碳排中减去一部分绿色电力,而是重新定义不同消费者对发电来源的碳排归属。
这种差异会不会传递到大模型应用?
硬件层面的核算差异会继续传递到上层应用。论文进一步将 STEC 用于重新计算已有工作中的大模型推理和训练隐含碳。
对于 LLM 推理,CarbonMin [3] 报告的结果为每 1000 次 GPT-3 推理请求约 0.31 g 隐含碳。采用 STEC-L-CS 后,结果范围为 0.21-0.35 g;其中最低值相对 0.31 g 的差异达到 32.26%。对于 LLM 训练,LLMCarbon [4] 的结果为 0.63 t,而 STEC-L-CS 的估计范围为 0.61-0.67 t,最大相对差异为 6.35%。
两类应用出现不同敏感度,主要与硬件来源的可选范围有关。推理系统中的内存和存储可能来自多个制造商和地区,制造地点与时间的组合更加丰富;训练场景中的硬件配置和制造来源更受限制,因此时空因素带来的波动相对较小。
真实处理器的隐含碳也不是一个固定数字
论文还对多款真实处理器进行了 STEC 核算。V100、A100 和 H100 的相对波动范围分别为 5.56%、7.26% 和 7.93%;Samsung 8nm 工艺的 Nvidia 3090 达到 16.13%。当同一处理器可能由多个晶圆厂生产时,差异会进一步扩大,例如 Apple A9 的相对范围达到 22.64%。
这些结果并不意味着某个地区或某种工艺天然“更绿色”,而是说明硬件隐含碳与制造背景密切相关。制造地点、制造时间、电网结构以及绿色电力的归属方式发生变化时,具体硬件实例的隐含碳也会变化。
这项工作对绿色计算意味着什么?
过去,绿色计算中的碳感知方法更多聚焦运行阶段,例如选择更低碳的时间运行任务,或把工作负载调度到更低碳的数据中心。随着计算设备能效提升和硬件制造复杂度增加,制造阶段的隐含碳正在成为全生命周期碳排中越来越重要的一部分。
STEC 的核心意义,在于把“硬件碳足迹”从一个静态的产品类别标签,转变为与实际制造背景相关的核算结果。这种变化会影响至少三个层面:
- 硬件碳核算:区分同一产品类别中的具体制造差异,减少平均值对实例差异的掩盖。
- 系统设计与采购:当硬件来源可选时,制造地点、制造时间以及供应商的绿电采购方式都可能成为新的碳评价维度。
- AI 应用评估:LLM 训练、推理等应用的隐含碳结论,会继承底层硬件核算模型中的不确定性和偏差。
从“这类芯片有多少碳”,到“这颗芯片是怎样制造出来的”
用一个平均值描述一类 CPU、GPU、内存或存储,便于快速估算,但也会把产品实例之间真实存在的差异压缩掉。当绿色计算逐渐进入更精细的采购、系统设计和 AI 碳核算场景时,仅依赖产品类别平均值已经难以完整反映制造过程。
STEC 所强调的问题可以概括为:硬件隐含碳不仅取决于“它是什么”,还取决于“它在哪里制造、何时制造,以及制造用电如何被归属”。把这些因素纳入核算,是从产品类别平均值走向实例级碳核算的一步。
参考文献
[1]Xiaoyang Zhang, Yijie Yang, and Dan Wang, “Spatial-Temporal Embodied Carbon Models With Dual Carbon Attribution for Embodied Carbon Accounting of Computer Systems,” IEEE Transactions on Computers, Vol. 74, No. 12, 2025, pp. 4037-4049. DOI: 10.1109/TC.2025.3605743.
[2] U. Gupta et al., “ACT: Designing Sustainable Computer Systems with an Architectural Carbon Modeling Tool,” ISCA, 2022.
[3]A. A. Chien, L. Lin, H. Nguyen, V. Rao, T. Sharma, and R. Wijayawardana, “Reducing the carbon impact of generative AI inference (today and in 2035),” in Proc. 2nd Workshop Sustain. Comput. Syst. (HotCarbon), 2023, p. 9.
[4] A. Faiz et al., “LLMCarbon: Modeling the End-to-End Carbon Footprint of Large Language Models,” ICLR, 2024.