百万网格放不进 GPU 显存,神经算子只能在网格样本上训练,每次只看到一部分边界条件。我们提出 SCANO,用两个即插即用模块让采样训练与整网格训练保持一致,并以不到一秒的单次前向预测整个数据中心机房。
在一个风冷数据中心机房里,十几台到两百多台服务器同时发热。冷却单元把冷风从地板下送入冷通道,服务器把热风排向机柜背后的热通道,热空气再回到冷却单元。服务器的进风温度有严格的热工规范 [1],所以热工工程师要回答的问题都很具体:哪些服务器有过热风险?某个机柜的功率升高、某台冷却单元的风量减小时,各台服务器的进风温度会怎样变化?
每回答一个这样的问题,都需要做一次计算流体力学(CFD)仿真:在约一百万个网格单元上求解稳态、带浮力的湍流。在我们的测试中,一个机房从划分网格到完成求解需要将近二十分钟。
神经算子(neural operator)走的是另一条路:直接学习从边界条件到物理场的求解映射。训练好之后,预测一个物理场只需要数值求解器耗时的一小部分 [2–4]。
但到了百万网格的工程问题上,神经算子先要过 GPU 显存这一关。本文介绍我们组的工作 SCANO,它关心的是显存限制带来的一个具体问题:当模型只能在网格的采样子图上训练时,边界条件应当如何聚合、如何注入,才能让训练出的模型与完整网格训练的模型一致。
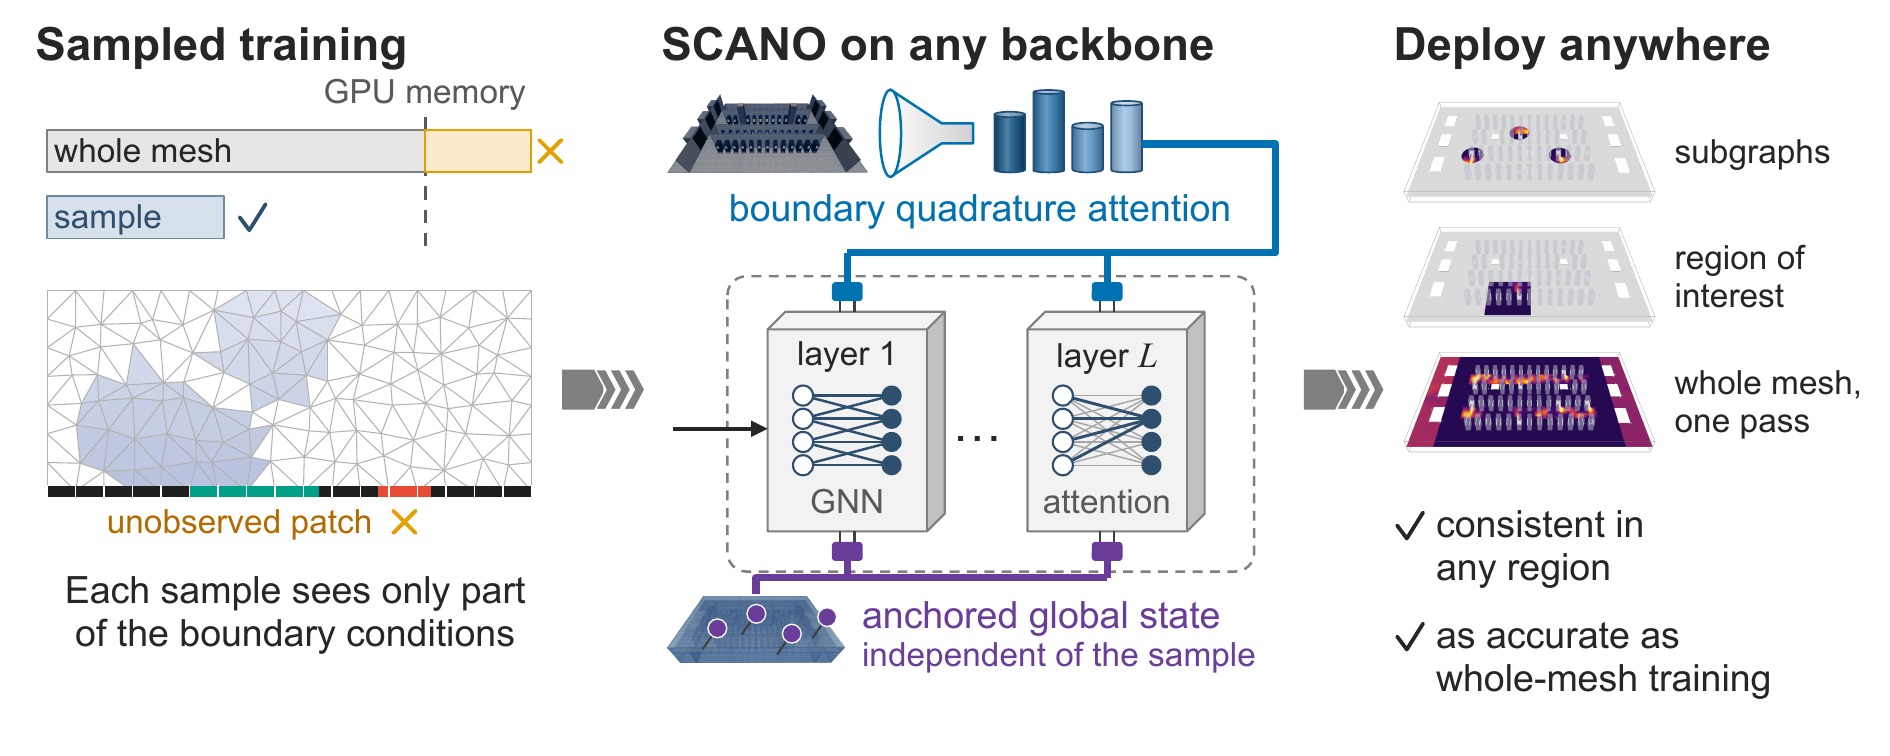
一次放不下整张网格:采样训练是一种折中
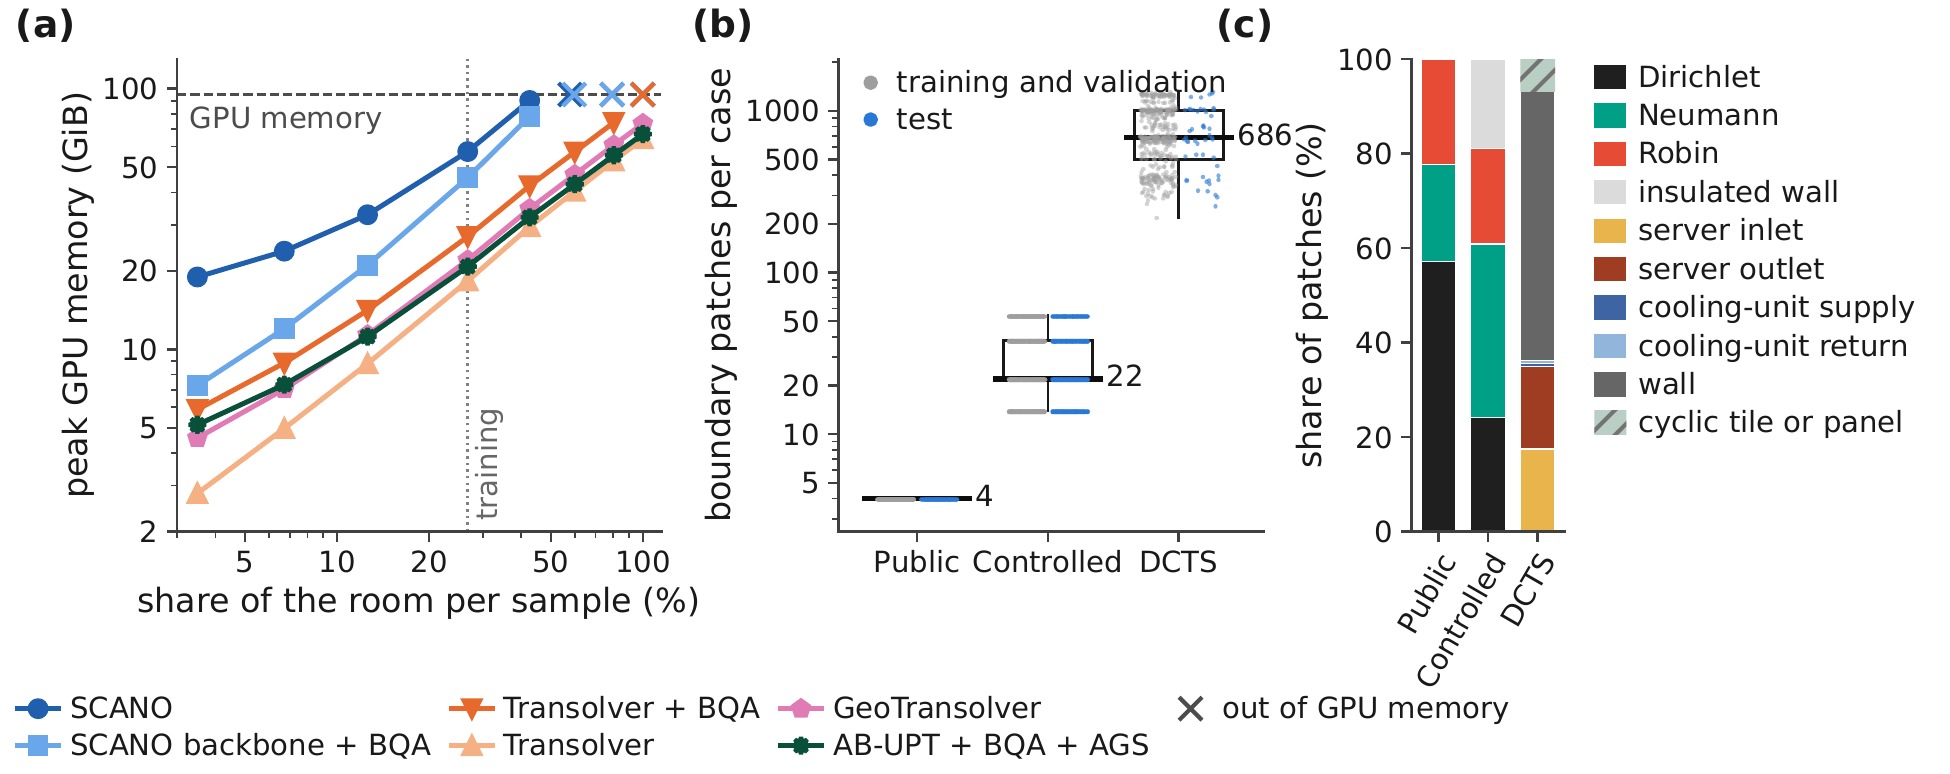
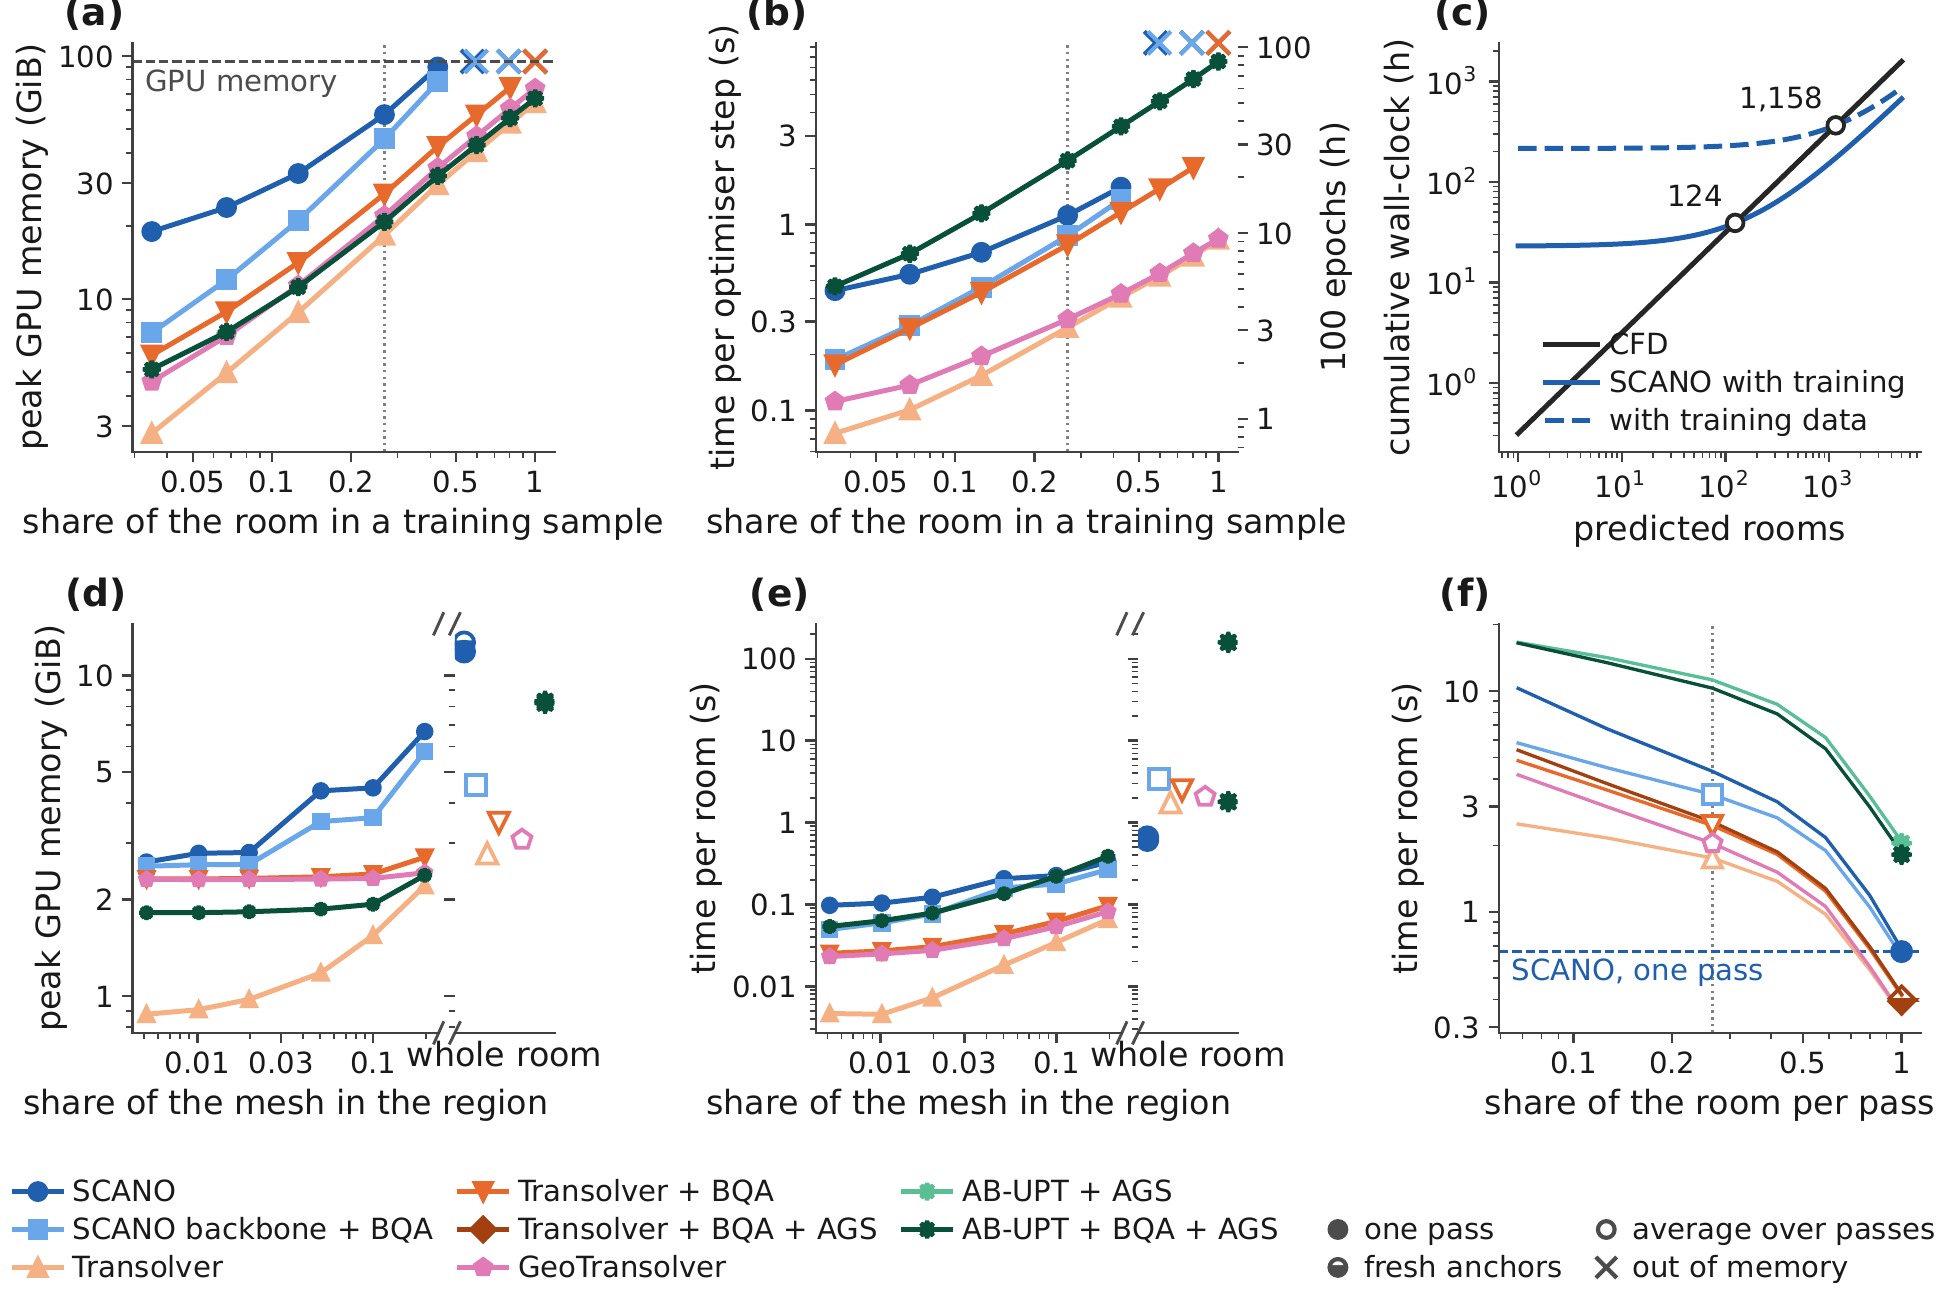
训练神经算子时,一个训练步所需的显存随网格规模增长。在一个约百万网格的 DCTS 机房上,对整个房间做一次训练步,每一种主干网络都要占用单张 GPU 的大部分显存。带消息传递的 SCANO 主干则直接超出显存(图2a)。网格再大一些,所有主干都会超出单张 GPU 的显存。
一种办法是把网格切分成带晕区(halo)的子图,做区域分解。不做区域分解时,则直接在网格的采样子图上训练:随机抽取一部分点 [5]、随机抽取锚点 [4],或者从随机种子出发生长出局部子图 [6]。训练完成后,再把模型部署到整张网格,或者只部署到工程师关心的局部区域。
这些做法都是显存限制下的折中,受影响最大的是边界条件是否能被完整考虑。
每个采样子图只看得到一部分边界条件
在我们构建的数据中心数据集 DCTS 中,每个机房有数百个边界区块(patch),多的超过一千个。它们分属服务器进风口、服务器出风口、冷却单元的送风口与回风口、墙面、开孔地板等不同的物理角色(图2b、c)。同一个区块内,面元的面积也可能相差几个数量级。每个区块都有自己的给定值、换热系数、通量或热负荷,机房内部的温度场与速度场就由这些边界数据决定。
神经算子要把这些边界信息送到计算域内的每一个点,通常分两步。第一步是聚合:把边界面元的数据整理成网络能读取的形式,例如边界节点的特征、一个汇总向量或一组 token。第二步是注入:把这些信息送进计算域内的点,可以只在输入层注入一次,也可以在每一层注入。采样训练时,这两步都可能出错。
在模型的一次前向过程中,一个采样子图样本能覆盖 DCTS 机房中近 40% 的内部网格单元,却只覆盖约三分之一的服务器出风口,而服务器出风口是整个机房热场的热源。最容易漏掉的是最小的区块,比如单台服务器的出风口、冷却单元的格栅,而工程师关心的变化多半就来自这些地方。
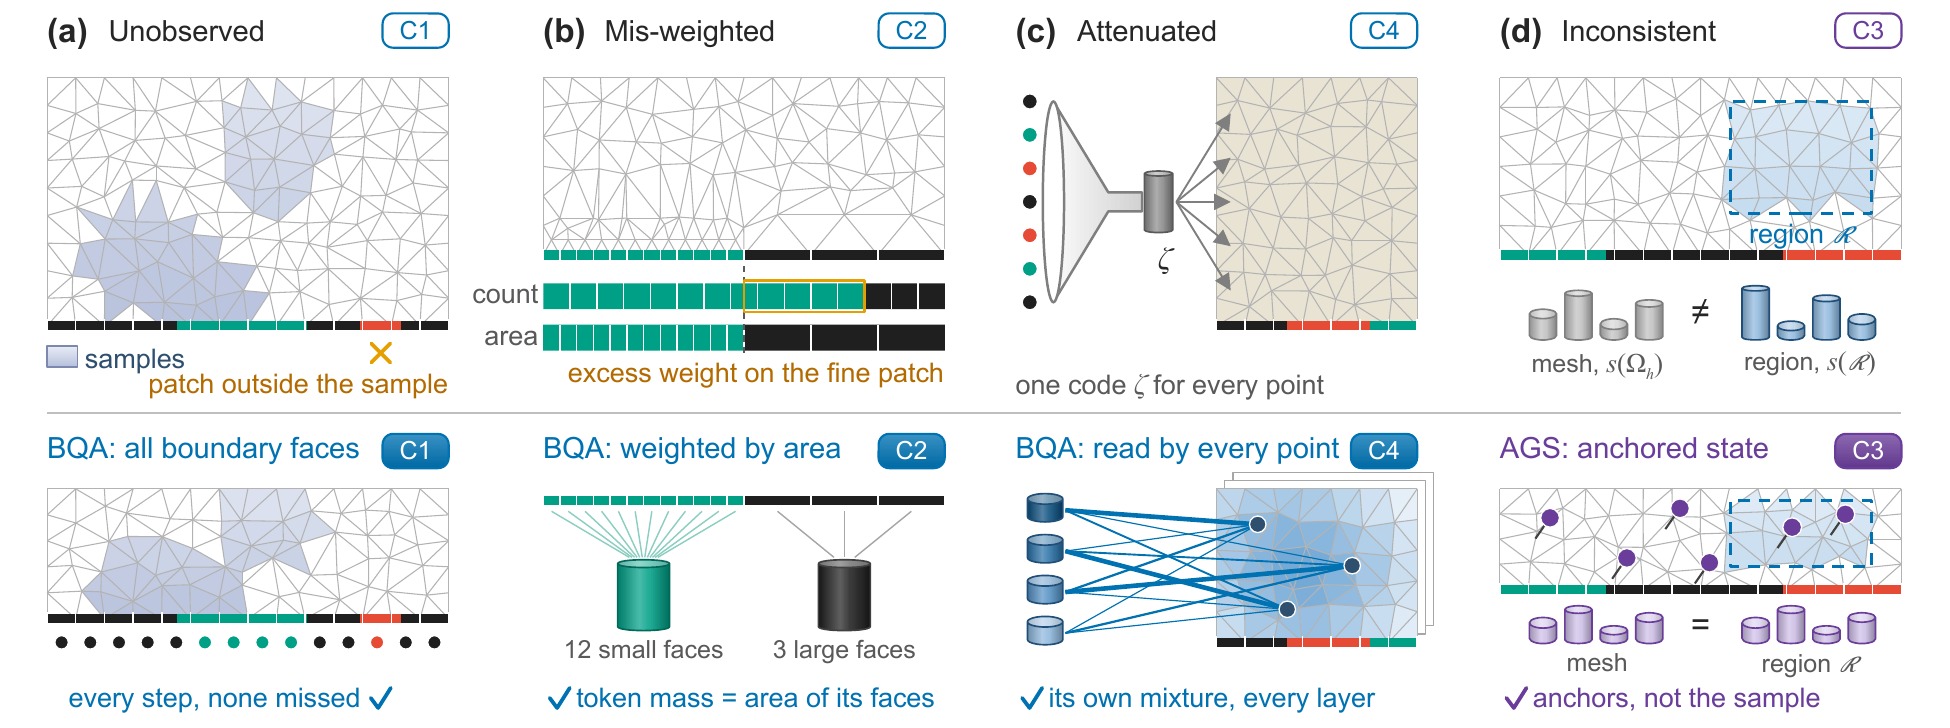
采样训练导致的边界条件四种失真
为了把问题说清楚,我们从边界测度的角度来看求解映射。对线性的、由边界驱动的问题(如受控基准中的对流–扩散问题),解可以精确地写成边界数据对一组边界测度的积分。对数据中心的浮力湍流,这一表示在流场固定时对温度成立,其余情形则作为设计上的指导。直观地说,给定的边界值(如给定温度)以加权平均的方式进入解,权重总和为一。通量(如热流)则以按面积累加的方式进入解。边界的类型决定了它使用哪一种测度,所以只知道数值而不知道类型,无法确定解。服务器则把自己的进风口与出风口耦合在一起:出风温度等于进风平均温度加上由功率和风量决定的温升。
这样看,任何边界编码方式都是在用离散的边界面元近似这些积分,也就是一种数值求积。注意力机制本身也可以看作对积分算子的离散 [7]。采样训练会从四个方面破坏这种求积,可以归为三类失效:采样依赖、测度失配,以及注入与压缩损失(图3)。
1. 采样丢失的边界条件(unobserved)
如果模型只通过采样到的边界节点读取边界,样本之外的区块在这一步就完全缺席。对这些区块上的干预,模型没有任何响应。
2. 边界Patch权重不匹配(mis-weighted)
如果按面元个数而不是面积来聚合,权重会偏向网格划分更细的区块。这种偏差不会随网格加密而消失。
3. 所有边界Patch聚合被压缩(attenuated)
如果把全部边界信息压成一个低维向量,再广播给所有点(例如 FiLM [8] 一类的全局调制),小的局部源项就会被抹平。
4. 采样子图与整体网格不一致(inconsistent)
许多主干网络会在每一层计算一个概括整个计算域的全局状态。如果它由当前样本计算,就会随每一次采样而变化。部署到一个小区域时,预测会明显偏离整网格预测。
结果是,模型的预测除了取决于物理,还取决于网格怎样采样、怎样离散。据我们所知,此前还没有工作系统地研究过这个问题:当神经算子在大网格的采样子图上训练时,异构、分区块的边界条件应当如何表示、聚合与注入。
所以,我们要回答的问题是:
神经算子的边界条件化需要满足哪些条件,才能让在网格的采样子图上训练的模型与整网格训练的模型一致?又如何以随网格规模线性增长的代价,在任意主干网络上满足这些条件?
从上面的积分表示出发,我们推导出完整的边界条件化需要满足的四个可测条件:信息完整性(C1)、网格一致性(C2)、样本一致性(C3)和响应保真度(C4)。这些条件是否被违反,在训练之前就可以通过采样器、面元密度与响应谱诊断出来。
SCANO:两个即插即用的模块
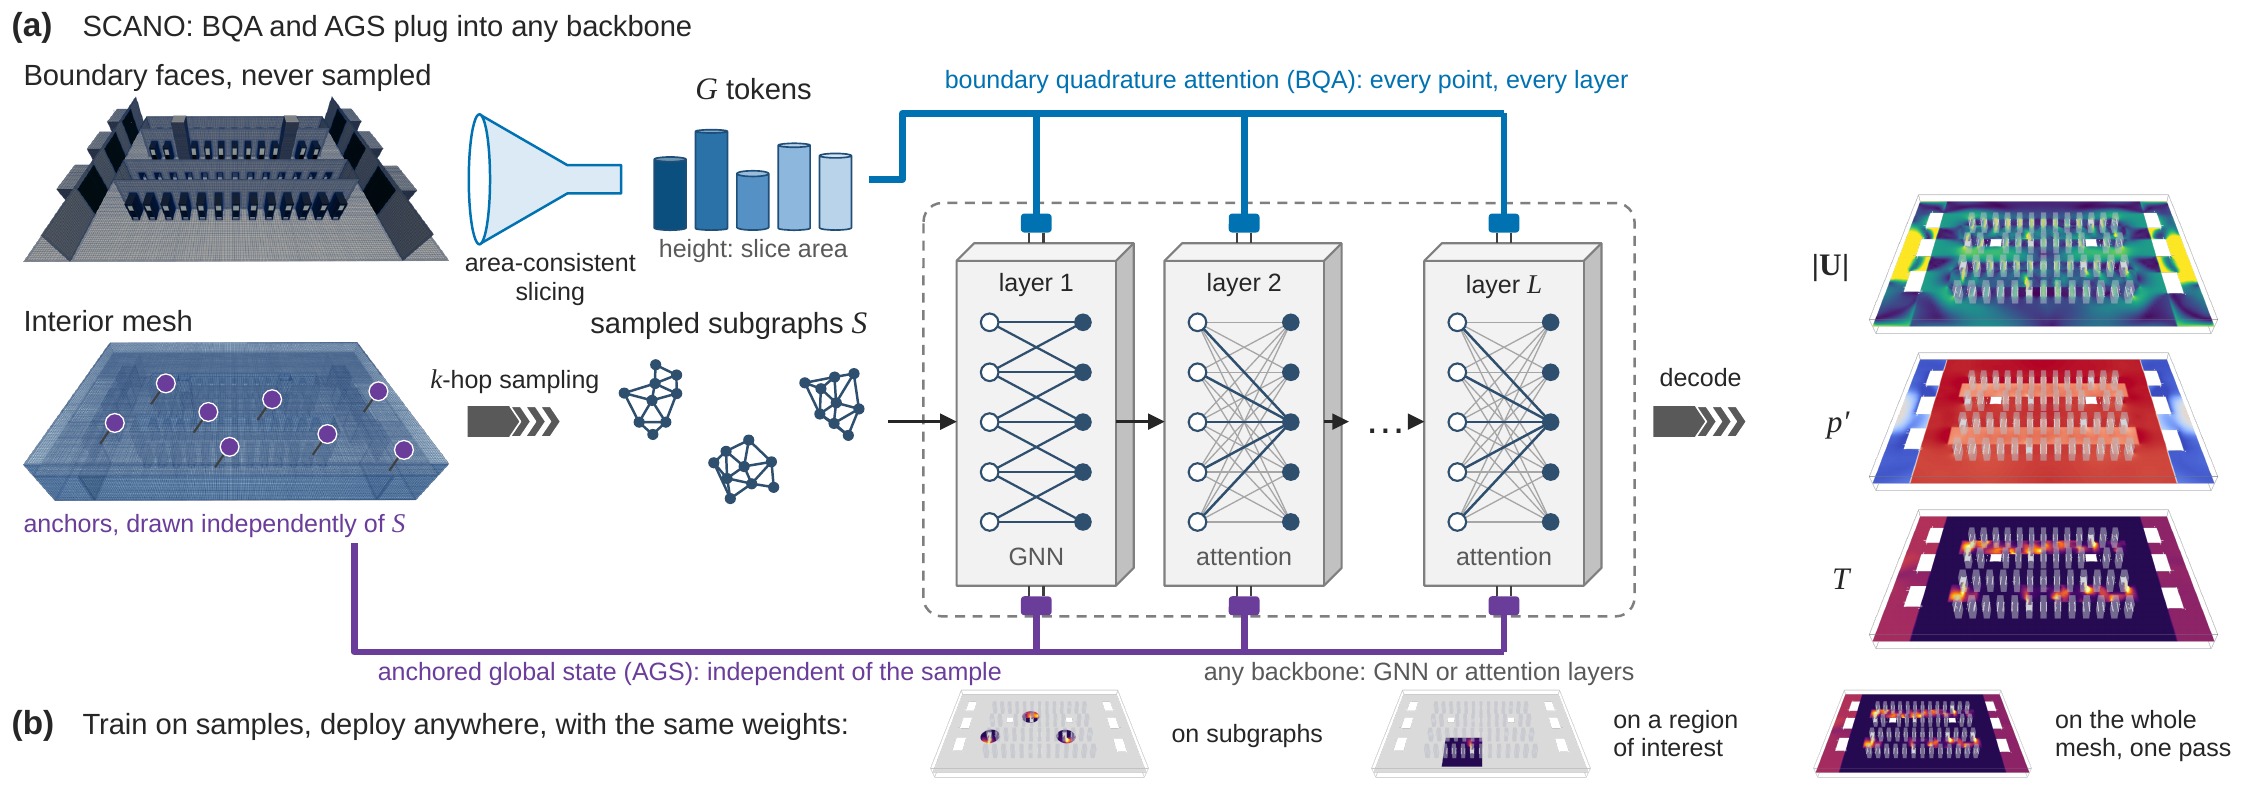
为了以线性代价满足这四个条件,我们提出了 SCANO(Sliced-Cross-Attention Neural Operator)。它的核心是两个与主干网络无关的模块(图4)。
1. 边界求积注意力(Boundary Quadrature Attention, BQA)
SCANO 只对计算域内部的点采样,从不对边界采样。每一个边界面元在每一步训练中都作为一条边界记录进入模型。记录包含面元的中心位置、外法向、边界类型和数值。面元面积不作为输入特征,而是聚合时的求积权重。因此,把一个面元拆成几块,只会让求积更精细,不会改变信息。
一个百万网格的机房有约五十万个边界面元,如果让每个点直接读取每条记录,代价太高。所以 BQA 在每次前向中把所有记录按面积加权,聚合成 G 个切片 token,计算域内的每一个点在每一层都读取这些 token。读取有两条路径:归一化路径传递平均量,如给定的温度;非归一化路径传递总量,如热通量与服务器温升。整个过程的代价随网格规模线性增长。
2. 锚定全局状态(Anchored Global State, AGS)
全局状态是样本影响预测的第二条途径。AGS 不再用训练样本计算全局状态,而是从一组按单元体积加权的锚点估计它。训练时,锚点在整张网格上抽取,与查询样本相互独立。部署到整张网格时,所有单元都是锚点,一次前向就能预测整张网格。部署到子图或局部区域时,重新抽取一组锚点即可。这样,训练与各种部署之间只剩下锚点的蒙特卡洛误差,而且它随锚点数的增加以已知的速率减小。
把这两个模块与一个在每层交替进行局部消息传递和切片注意力的主干网络结合,就得到了 SCANO。消息传递为每个点提供它所在网格邻域的精细分辨率。两个模块同样可以接入现有的主干网络。我们把它们接入了 Transolver [2]、AB-UPT [4]、AeroGTO [9]、GNOT [3]、GeoTransolver [10] 和 MeshGraphNets [11] 六个主干。
简单说,SCANO 在样本上训练,同一组权重可以部署到网格的任何区域。
实验:从精确解到工业级机房
我们在三个数据集上逐一检验这四个条件。
- 受控基准:单位立方体内的线性对流–扩散问题,带有回流速度场。它有精确的参考解,边界区块的数量、面积与类型都由设计给定,可以对单个区块做精确的干预。
- 公开基准:LFE 工作 [12] 提出的单位圆盘上的混合边界 Poisson 问题,边界分为 Dirichlet、Neumann 与 Robin 三类。
- DCTS(Data Center Thermal Simulation):我们构建的工业数据集,包含 500 个约百万网格的机房。各机房共享建筑外壳,内部布局各不相同:服务器从 18 台到 273 台,冷却单元从 2 台到 6 台,开孔地板、隔断和柱子的布置也各不相同。每个机房都有自己的网格,参考解由 OpenFOAM 求解稳态浮力 RANS 方程得到。我们还为测试机房生成了单一干预的配对算例:把一个机柜的功率加倍,或把一台冷却单元的风量减半。
理论在训练之前给出了四条预测,实验都验证了:一个样本能观测到的边界比例、按个数加权在网格加密下的误差平台、由样本计算的全局状态的部署漂移,以及全局编码的秩下界。
BQA 让模型更准
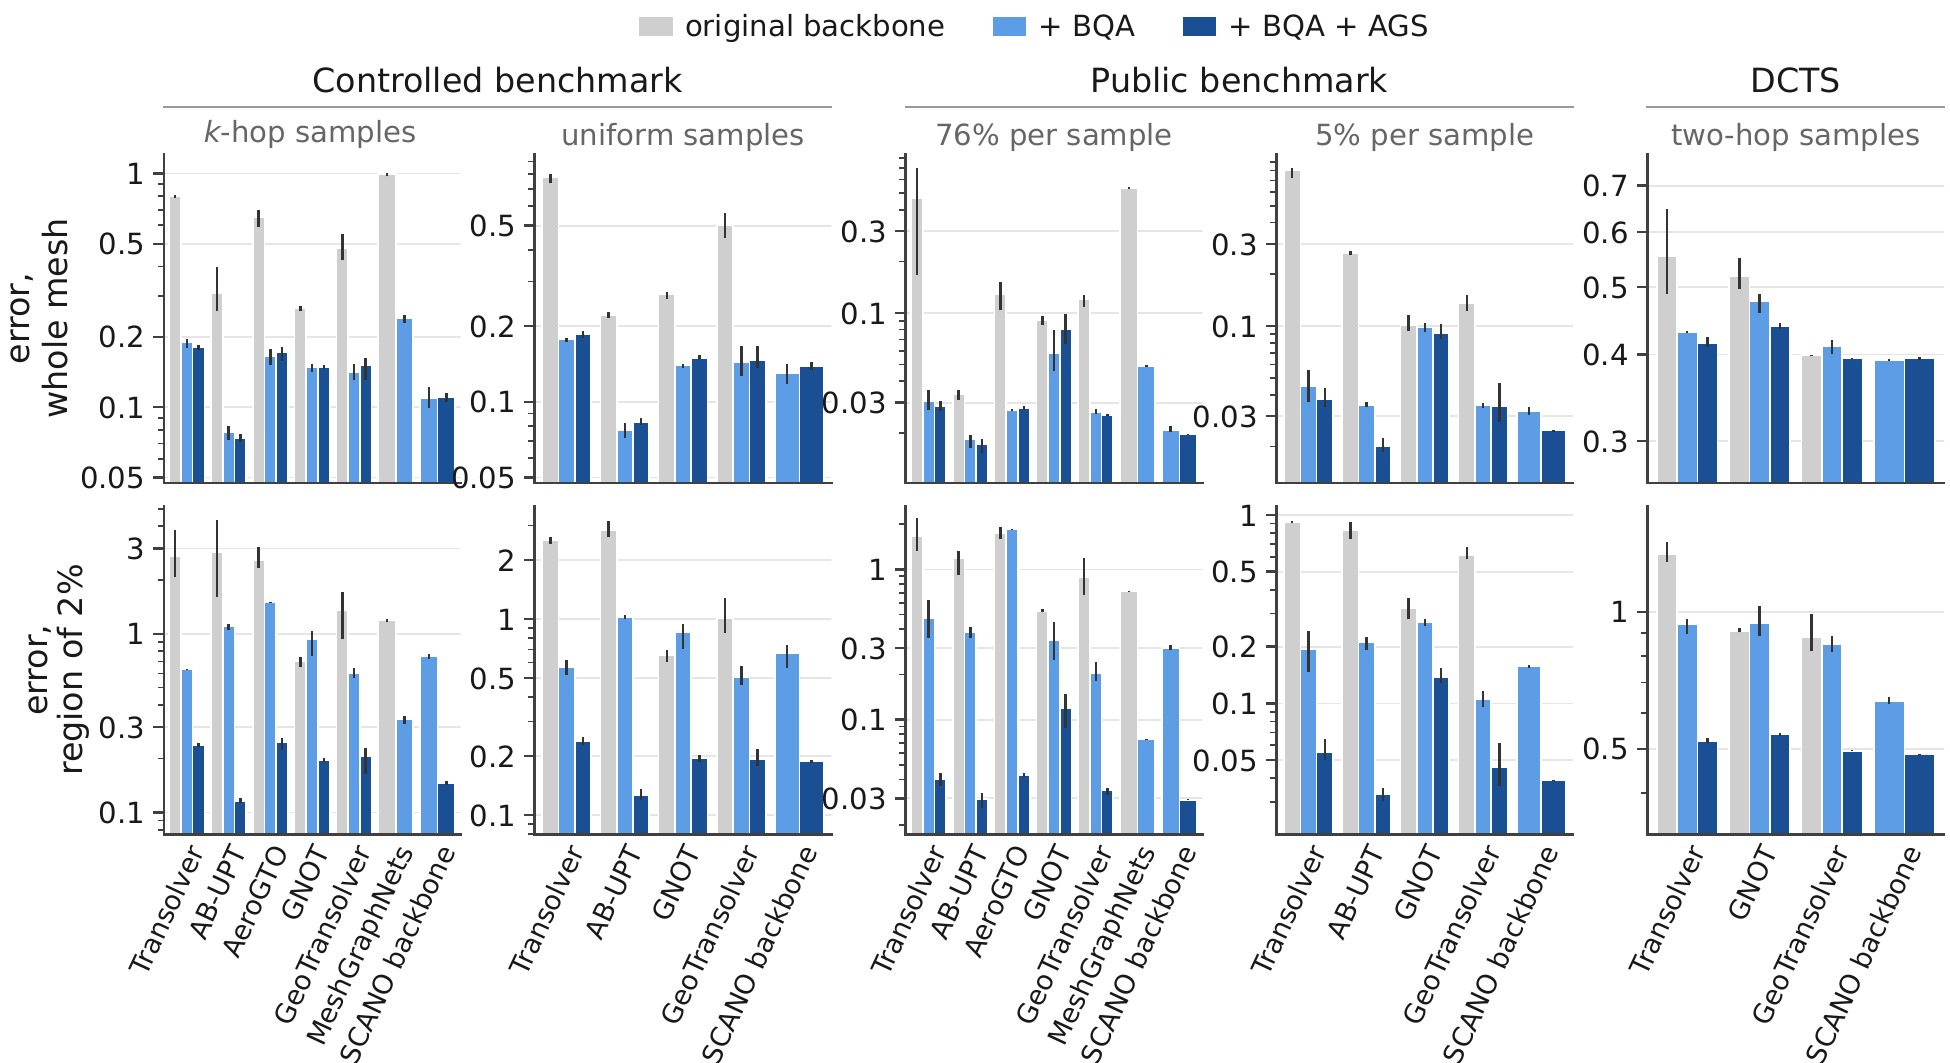
在两个基准上,BQA 降低了它接入的每一个主干的整网格误差,最多降至原来的十五分之一(图5 上排)。收益最大的是原本只通过采样边界节点读取边界的主干:Transolver、AeroGTO 和 MeshGraphNets 的误差下降了数倍乃至一个数量级以上。GeoTransolver 和 AB-UPT 已经通过几何上下文或锚点集关注边界,BQA 对它们的提升依然明显。
AGS 让模型在任何区域都一致
在全部三个数据集上,AGS 都让局部区域的预测与整网格预测保持一致,差别只在锚点的蒙特卡洛误差以内。在公开基准上,当每个训练采样子图覆盖约 76% 的网格时,它把多数主干的区域误差降低了一个数量级以上;样本更稀疏时,也能降低数倍(图5 下排)。相比之下,全局状态由区域重新计算的模型,误差随区域缩小而增大。在 DCTS 的小区域中,它们的误差可达自身整网格温度误差的约三倍。
两个模块一起用时,在两个基准上,原生主干中表现最好的那个,整网格误差接近减半。
采样训练不必牺牲精度
那么,采样训练本身会不会损失精度?在 DCTS 上,Transolver 可以把整个机房放进显存训练,因此可以直接比较。加上 BQA 与 AGS 后,在子图样本上训练的 Transolver 精度略高于整机房训练,每轮训练时间却不到后者的三分之一。原生 Transolver 在采样训练下则明显损失精度。也就是说,在这组对比中,只要边界条件化完整,显存限制下的采样训练没有带来精度损失。
数据中心机房热场模拟
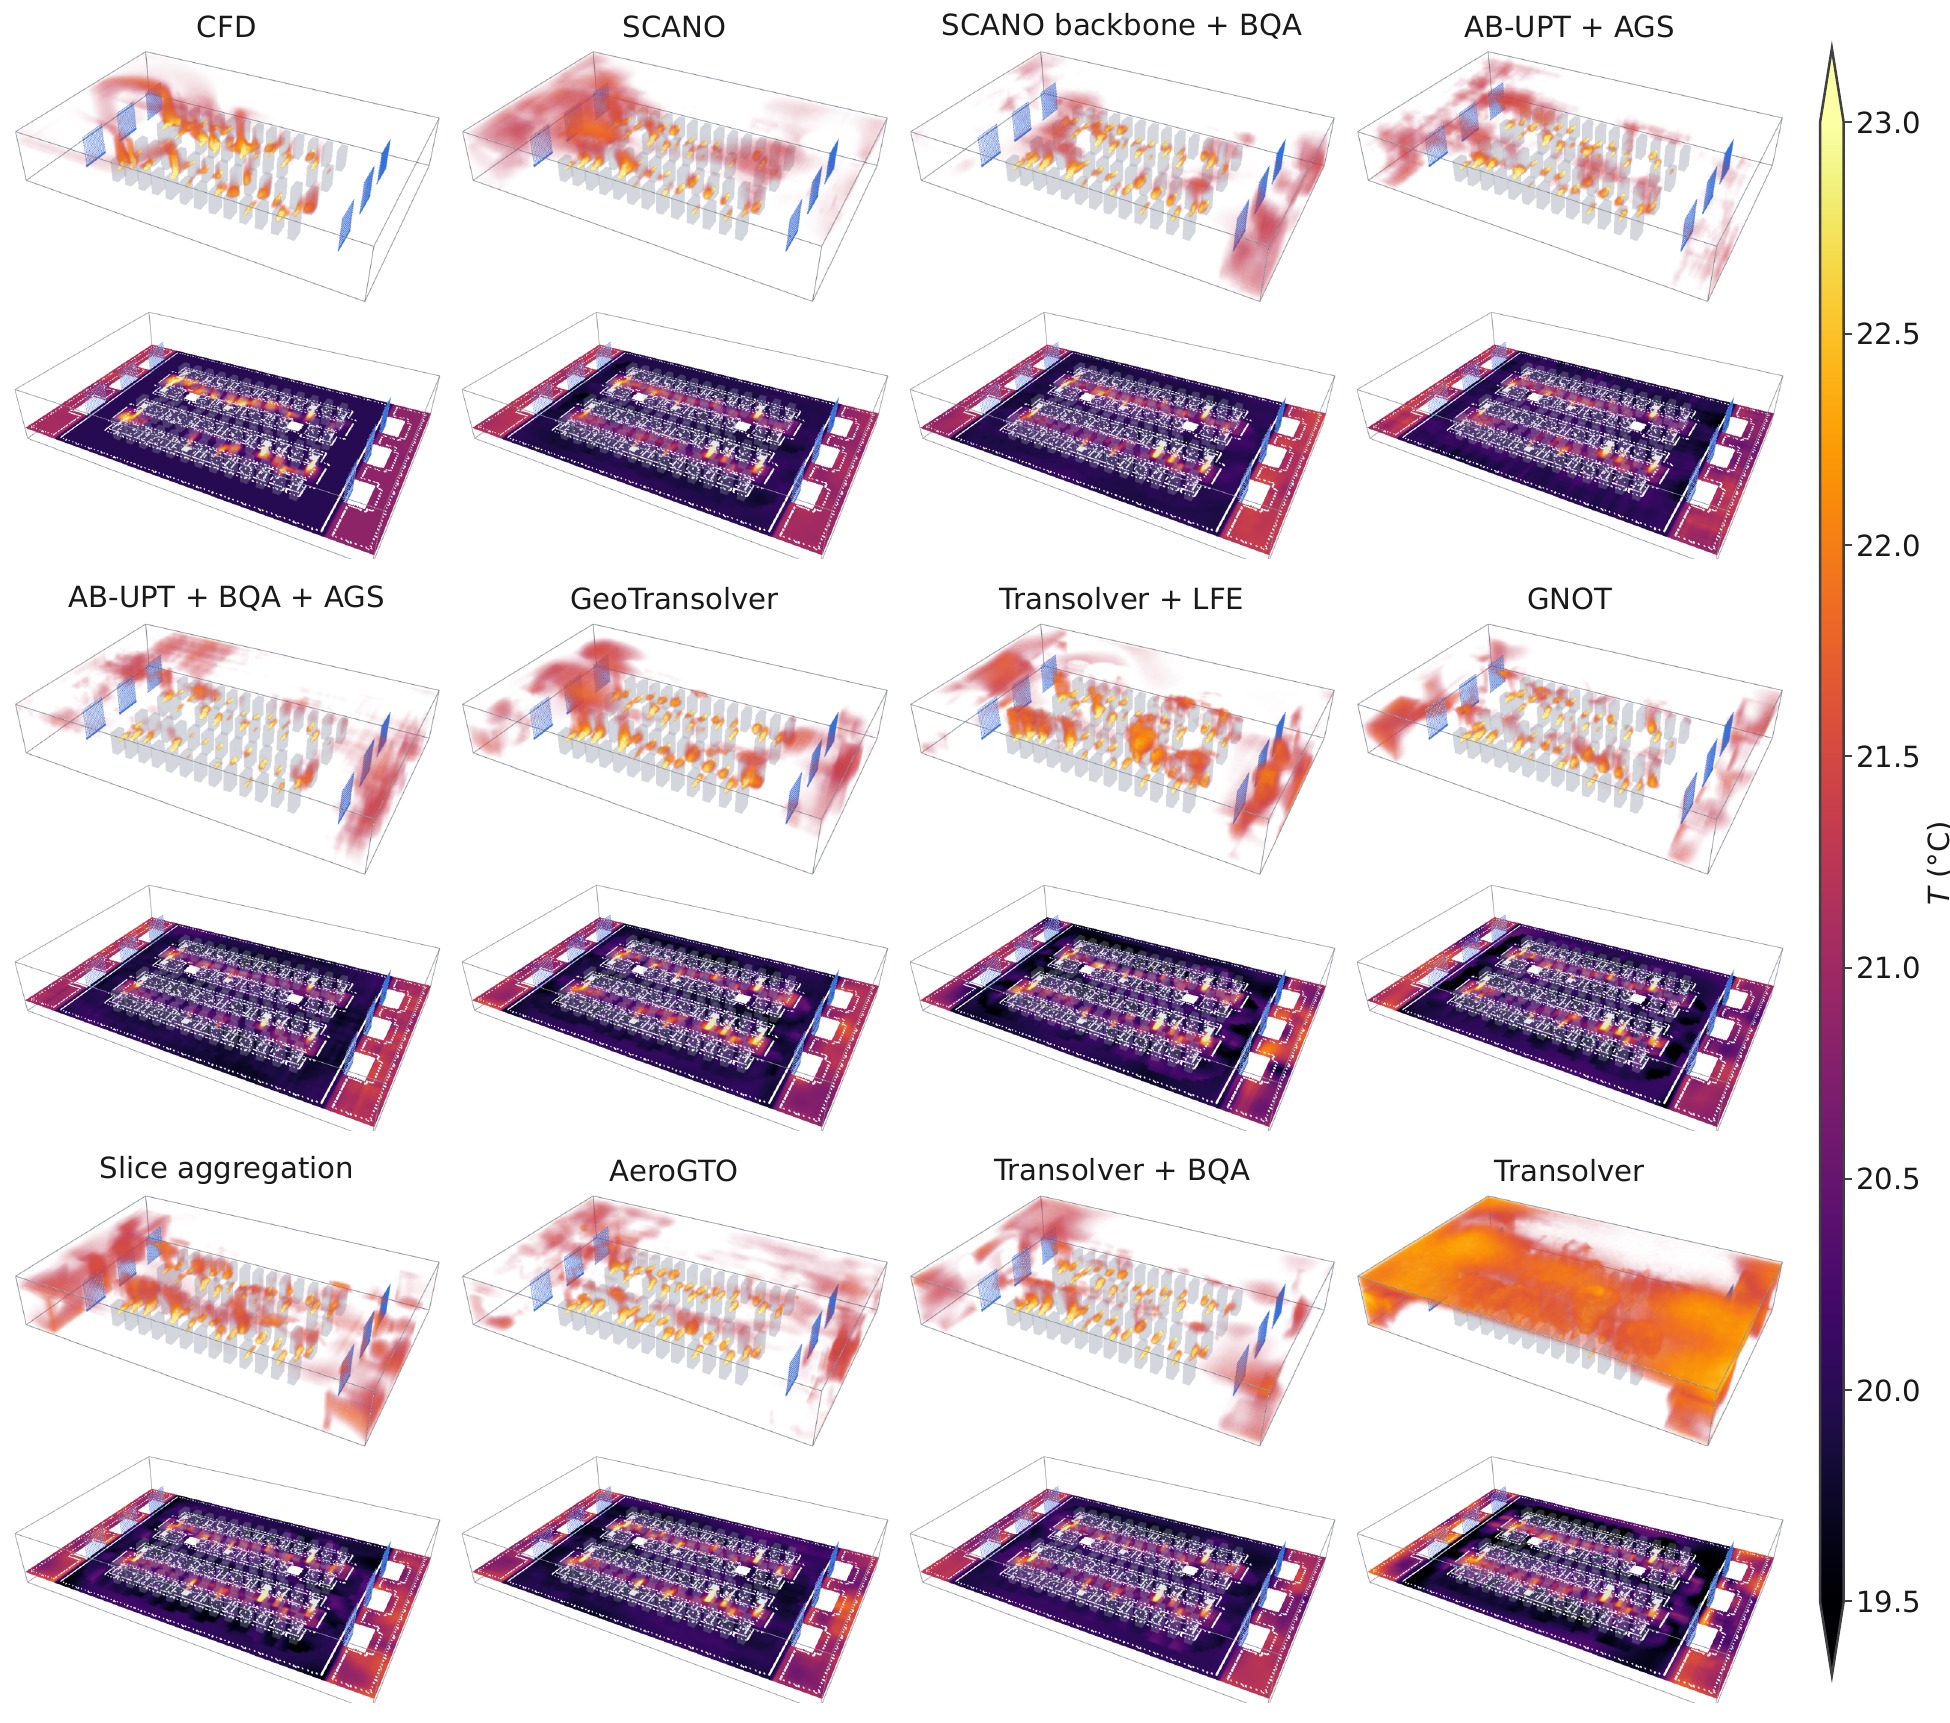
图6 是一个测试机房的三维温度场。在 CFD 解中,每个机柜上方都升起一股独立的排风热羽流。这些羽流汇入天花板下方的暖空气层,再流向冷却单元。SCANO 和接入 AGS 的 AB-UPT 逐股复现了这些羽流。原生 Transolver 只通过采样的边界节点看到边界,把房间上部整体算得过热。给同一个主干接入 BQA 后,各个机柜的羽流重新出现。
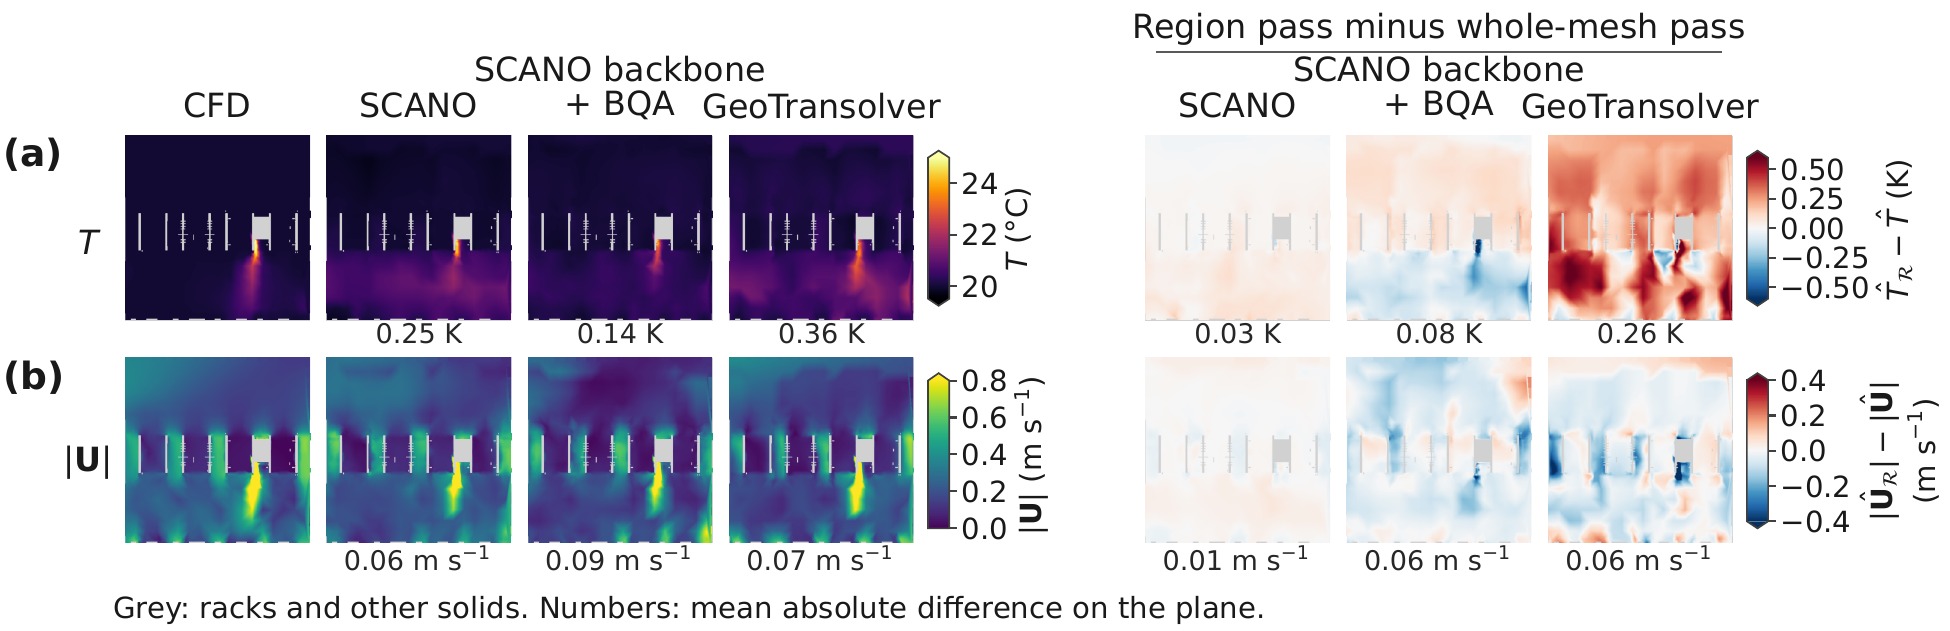
工程师的日常问题往往是局部的。图7 中,我们只预测进风温度最高的那个机柜周围的区域,约占房间体积的 6%。SCANO 的全局状态不依赖所查询的那部分网格,因此单独预测这个区域时,结果与它的整网格预测几乎一致。SCANO 主干 + BQA 由区域重新计算全局状态,冷通道上的速度预测出现了明显偏移。GeoTransolver 在整网格上与 SCANO 精度相当,但在这个区域里把整个区域算得偏热。
模型还需要对边界的变化做出正确响应。把一台冷却单元的送风量减半,最能区分不同的方法。在每一层都读取边界记录的模型,包括 SCANO 的各个变体、接入 BQA 的主干、GeoTransolver 和 GNOT,在每一个训练种子下都能捕捉到机房的热响应。只通过采样边界节点读取边界的原生 Transolver 和 AeroGTO、锚点只含部分边界面元的 AB-UPT + AGS,以及只在输入层读取边界记录的 Transolver + LFE,在部分训练种子下则捕捉不到这一响应。接入 BQA 后,Transolver 和 AB-UPT 在每一个训练种子下都能稳定响应,响应误差也下降了一半以上。
最后是速度(图8)。SCANO 一次前向就能预测整个机房,耗时不到一秒,比以全部单元为锚点、在整个房间上做锚点自注意力(AB-UPT 的整网格部署方式)快 100 倍以上。算上划分网格、一次求解器迭代(用于得到初始边界值)和特征提取,SCANO 的端到端时间不到完整 CFD 求解的一半,其中的网格划分 CFD 本来也需要。预测约 120 个机房之后,训练成本即可收回;若把生成训练数据的 CFD 也计入,约 1,200 个机房后收回。
结语
对在网格上采样子图训练的神经算子来说,边界条件怎么编码,决定了模型能否与整网格训练保持一致。把边界条件写成依赖于边界类型的测度上的求积之后,失效模式、一致性条件和架构上的对策都可以由此推出,并且不依赖具体的主干网络。这四个条件,加上切片 token 和锚点两种即插即用的编码部件,构成了一份可为神经算子在百万网格上提升采样训练性能的框架。这套方法适用于任何能把边界条件写成带类型的面元记录的问题:Dirichlet、Neumann、Robin 条件,入流与出流,以及像服务器这样的耦合热源。数据中心只是其中一例,其他大网格上、由边界驱动、带有局部源项的系统,也有望用同样的思路处理。DCTS 数据集、受控基准及其生成器,以及 SCANO 与免训练检查的代码,将在论文被接收后公开。
论文信息
标题:SCANO: Restoring Boundary-Condition Completeness in Sampled Meshes with a Sliced-Cross-Attention Neural Operator for 3D Thermal Fields
作者:Tianyu Li, Zhiwei Cao, Qingang Zhang*, Ruihang Wang, Binyang Song, Yonggang Wen(*通讯作者)
引用文献
[1] Quirk D, Davidson T, Schmidt R. ASHRAE’s data center thermal guidelines—air-cooled evolution[J]. ASHRAE Journal, 2022, 64(7): 24-29.
[2] Wu H, Luo H, Wang H, et al. Transolver: A fast transformer solver for PDEs on general geometries[C]//Proceedings of the 41st International Conference on Machine Learning (ICML). PMLR, 2024, 235: 53681-53705.
[3] Hao Z, Wang Z, Su H, et al. GNOT: A general neural operator transformer for operator learning[C]//Proceedings of the 40th International Conference on Machine Learning (ICML). PMLR, 2023, 202: 12556-12569.
[4] Alkin B, Bleeker M, Kurle R, et al. AB-UPT: Scaling neural CFD surrogates for high-fidelity automotive aerodynamics simulations via anchored-branched universal physics transformers[J]. Transactions on Machine Learning Research (TMLR), 2025.
[5] Zhou H, Wu H, Shangguan H, et al. Transolver-3: Scaling up transformer solvers to industrial-scale geometries[C]//Proceedings of the 43rd International Conference on Machine Learning (ICML). 2026. (arXiv:2602.04940)
[6] Zeng H, Zhou H, Srivastava A, et al. GraphSAINT: Graph sampling based inductive learning method[C]//International Conference on Learning Representations (ICLR). 2020. (arXiv:1907.04931)
[7] Calvello E, Kovachki N B, Levine M E, et al. Continuum attention for neural operators[J]. Journal of Machine Learning Research, 2025, 26(300): 1-52.
[8] Perez E, Strub F, de Vries H, et al. FiLM: Visual reasoning with a general conditioning layer[C]//Proceedings of the AAAI Conference on Artificial Intelligence. 2018, 32(1): 3942-3949.
[9] Liu P, Wang P, Ren X, et al. AeroGTO: An efficient graph-transformer operator for learning large-scale aerodynamics of 3D vehicle geometries[C]//Proceedings of the AAAI Conference on Artificial Intelligence. 2025, 39(18): 18924-18932.
[10] Adams C, Ranade R, Cherukuri R, et al. GeoTransolver: Learning physics on irregular domains using multi-scale geometry aware physics attention transformer[EB/OL]. arXiv preprint arXiv:2512.20399, 2025.
[11] Pfaff T, Fortunato M, Sanchez-Gonzalez A, et al. Learning mesh-based simulation with graph networks[C]//International Conference on Learning Representations (ICLR). 2021.
[12] Mousavi S, Mishra S, De Lorenzis L. Imposing boundary conditions on neural operators via learned function extensions[C]//Proceedings of the 43rd International Conference on Machine Learning (ICML). 2026. (arXiv:2602.04923)